A TiaDor Stúdió a feleségem debreceni kreatív stúdiója: festős workshopokat és gyerekprogramokat árul WooCommerce-termékként. Korábban minden eseményt kézzel kellett összerakni a WordPress adminban: cím, leírás, dátum, ár, helyek száma, SEO-cím, meta leírás, slug, kép. Most a telefonján csinálja egy kis appban, amit én írtam: bemásolja a szöveget, amit amúgy is megírt a Facebookra, hozzáteszi a plakátot, a többit pedig kitölti egy nyelvi modell.
Abban nincs semmi különös, hogy egy LLM kitölti a SEO-mezőket, ezt bárki összerakja egy délután alatt. Az érdekesebb az, ami élesben elromlott. Szinte minden javításnál ugyanaz történt: elvettem egy feladatot a modelltől, és megírtam sima Pythonban.
Mit csinál az app?
A technológia szándékosan unalmas: Vue 3 PWA a Cloudflare Pagesen, FastAPI backend Dockerben egy VPS-en, adatbázis nincs. A backend csak közvetít a WordPress és a WooCommerce REST API felé, saját adatot nem tárol: minden a webshopban van.
Egy esemény feltöltése két lépésből áll, és ez a szétválasztás a projekt legfontosabb döntése:
- Kitölti a minimumot (fotó, név, leírás, dátum, ár), és megnyomja az „AI generálás ✨” gombot. A backend elküldi a modellnek a szöveget és az 1280 pixelesre kicsinyített plakátot. Visszakapja a SEO-címet, a meta leírást, a rövid leírást, a slugot, a kategóriákat, a címkéket, és ha a szövegben vagy a plakáton talált, a dátumot és az időtartamot.
- Minden generált értéket átírhat. A WordPressbe csak akkor kerül fel bármi, amikor a „Közzététel” vagy a „Feltöltés piszkozatként” gombra bök: ekkor az app átméretezi és feltölti a képet, és létrehozza a terméket a Yoast- és ACF-mezőkkel együtt.
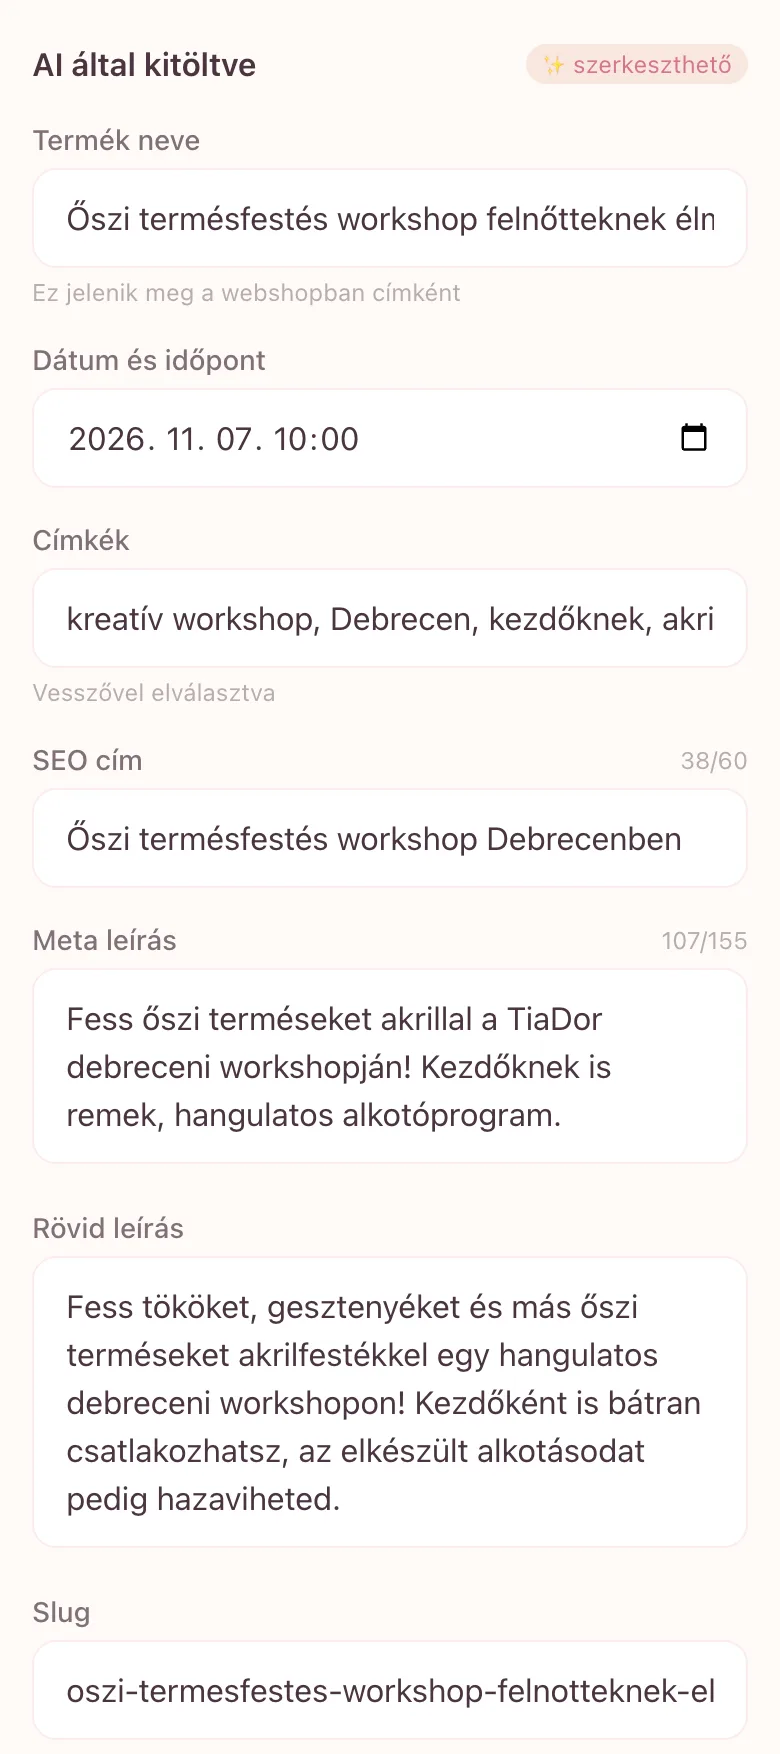
Ha a modell épp nem érhető el, az űrlap akkor is működik, a SEO-mezőket kézzel is ki lehet tölteni. Az az AI-funkció, ami miatt egy kisvállalkozás nem tud publikálni, többet árt, mint amennyit használ.
Hat feladat, amit a kód vett vissza
Mindegyik hiba legalább egyszer élesben is megjelent, mielőtt kijavítottam. Valójában ez az esettanulmány lényege.
1. Slug. A prompt azt kérte a modelltől, hogy írjon ékezet nélküli magyar slugot. Szeptemberben a „Gyertyadíszítő” szóból gyertyadisito lett, elveszett egy „z”, és ez az URL élesbe került, meg is osztották. Az ékezetek eltávolítása egyértelmű, gépiesen megoldható feladat, nem kell hozzá nyelvi modell. A slug elejét most egy rövid függvény állítja elő a végleges címből. (Az ő-höz és az ű-höz külön cseretábla kell, mert az é-vel ellentétben Unicode NFKD-vel nem bonthatók szét.) A modell slugjából már csak a dátumos végét használom.
2. Címkék. A modell néhány hetente kitalálta egy meglévő címke új írásmódját: oszi-szunet mellé osziszunet, korvaszon mellé korvazszon. Mindegyikből egy szinte üres címkeoldal lett. Két lépésben javítottam. A prompt most megkapja az oldal 60 leggyakoribb címkéjét, mentés előtt pedig minden címkét összepárosítok egy meglévővel: előbb ékezet, kisbetű-nagybetű és kötőjel nélküli kulcs alapján, elírásnál difflib-bel, 0,88-as küszöbbel. Új címke csak akkor jön létre, ha tényleg új.
3. Kategóriák. Nem volt elég felsorolni őket a promptban, a modell így is visszaadott nem létező slugokat. Most az OpenAI szigorú structured outputs módját használom: maga a JSON-séma csak a webshop valódi kategóriáit engedi meg a category_slugs mezőben (enum), és ezt a listát minden kérésnél frissen állítom össze. A modell akkor sem tud nem létező kategóriát visszaadni, ha akarna.
4. Rossz cím. Ez volt a legkínosabb. Néhány élő eseménynél a helyszínnél egy másik cég utcacíme szerepelt. A lemásolt események egy régi piszkozatból örökölték, ami még azelőtt készült, hogy a prompt megkapta volna a stúdió valódi címét. A prompt kijavítása a már elmentett adatokon nem segít, ezért most minden mentéskor lefut egy ellenőrzés: ha a helyszínnél nem az esemény saját címe áll, a kód kicseréli a helyesre.
5. A hét napjai. Ha egy eseményt új időpontra másolunk le, az „október 25-én, szombaton” típusú mondatokat át kell írni, a számtól függő ragokkal együtt. Ezt szándékosan a modellnél hagytam: a valódi leírásokban van „szeptember 13-i” és „Október 29-30.” is, egy reguláris kifejezés ezek egy részét szó nélkül kihagyná. A hét napját viszont a kód számolja ki, és készen adja át a modellnek. Utána a kód átnézi az átírt szöveget, és ha maradt benne régi dátum, figyelmeztetést mutat egy „szerkesztés” gombbal, és nem menti el szó nélkül.
6. Formázás. A Facebookról bemásolt szövegben minden bekezdés egyetlen sor, tele van láthatatlan, nulla szélességű szóközökkel, és a WordPress az egészet egyetlen, <br>-ekkel teli tömbként jelenítette meg. Kérhettem volna a modelltől, hogy „formázza meg szépen”. Nem tettem, mert ha a modell átírhatja a szöveget, át is fogja írni. Ehelyett egy szabályalapú formázó alakítja HTML-lé a címkés sorokat, a listákat és az alcímeket, és egyetlen szót sem ír át. Mielőtt az élő eseményeken lefuttattam, 14 valódi leíráson ellenőriztem.
Miben jó a modell?
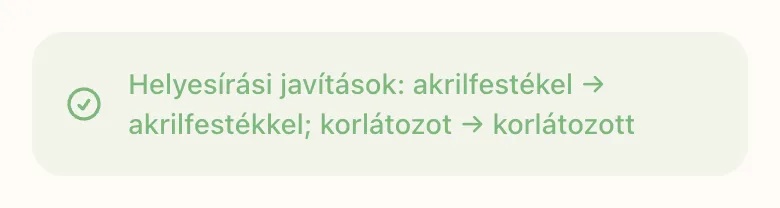
Mindezek ellenére a munka nagyját továbbra is a modell végzi, és jól. A stúdió hangján írja meg a meta leírást és a rövid leírást, leolvassa a plakátról a dátumot és az időpontot (egy valódi napközis tábor plakátjáról helyesen olvasta le, hogy „8:00–16:00”), és kijavítja az elírásokat. A javításokat listában adja vissza („hibás → javított”), és az eredeti szövegben csak ezeket a cseréket hajtom végre, így a megfogalmazás az övé marad.
A modell kiválasztása kevesebbet számított, mint a korlátok. Ugyanazokon a valódi termékeken összehasonlítottam a gpt-6-luna-t és a gpt-6.1-sol-t: a kategória-enum mellett mindkettő ugyanazokat a helyes kategóriákat és dátumokat adta. A nagyobb modell másfél-kétszer hosszabb leírásokat írt, és kétszer is oda nem illő címkét tett hozzá, így maradt a kisebb. A backend az Anthropic API-ját is támogatja, a váltáshoz egyetlen környezeti változót kell átírni.
A szabály, amit bármelyik LLM-projektbe vinnék
Ha egy szabályt pontosan meg lehet fogalmazni, annak a kódban a helye: ékezetmentesítés, milyen címkék és kategóriák léteznek, melyik a helyes cím, milyen napra esik egy dátum. A modell azt kapja, amihez ítélőképesség és nyelvérzék kell. A kimenete átmegy egy sémán és néhány ellenőrzésen, és élesítés előtt egy ember is ránéz. A fenti hibák mindegyikéből regressziós teszt lett. A backendnek 53 tesztje van, és a dátummal jelölt esetek többsége olyan hiba, ami élesben is előfordult.
Ebben semmi különleges nincs. A szokásos fejlesztői fegyelem, csak most egy olyan alkatrész körül, ami az esetek néhány százalékában magabiztosan téved. Pont itt térül meg igazán.
Segítsek?
Ha egy meglévő PHP-, WordPress- vagy Python-rendszerbe szeretnél nyelvi modellt építeni, és fontosabb, hogy unalmasan megbízható legyen, mint hogy egy demón látványos, akkor pont ilyen AI-integrációval foglalkozom. Írd meg, min dolgozol.
Források